2026 年 9 月 18 日,星期五 · 10 条精选资讯
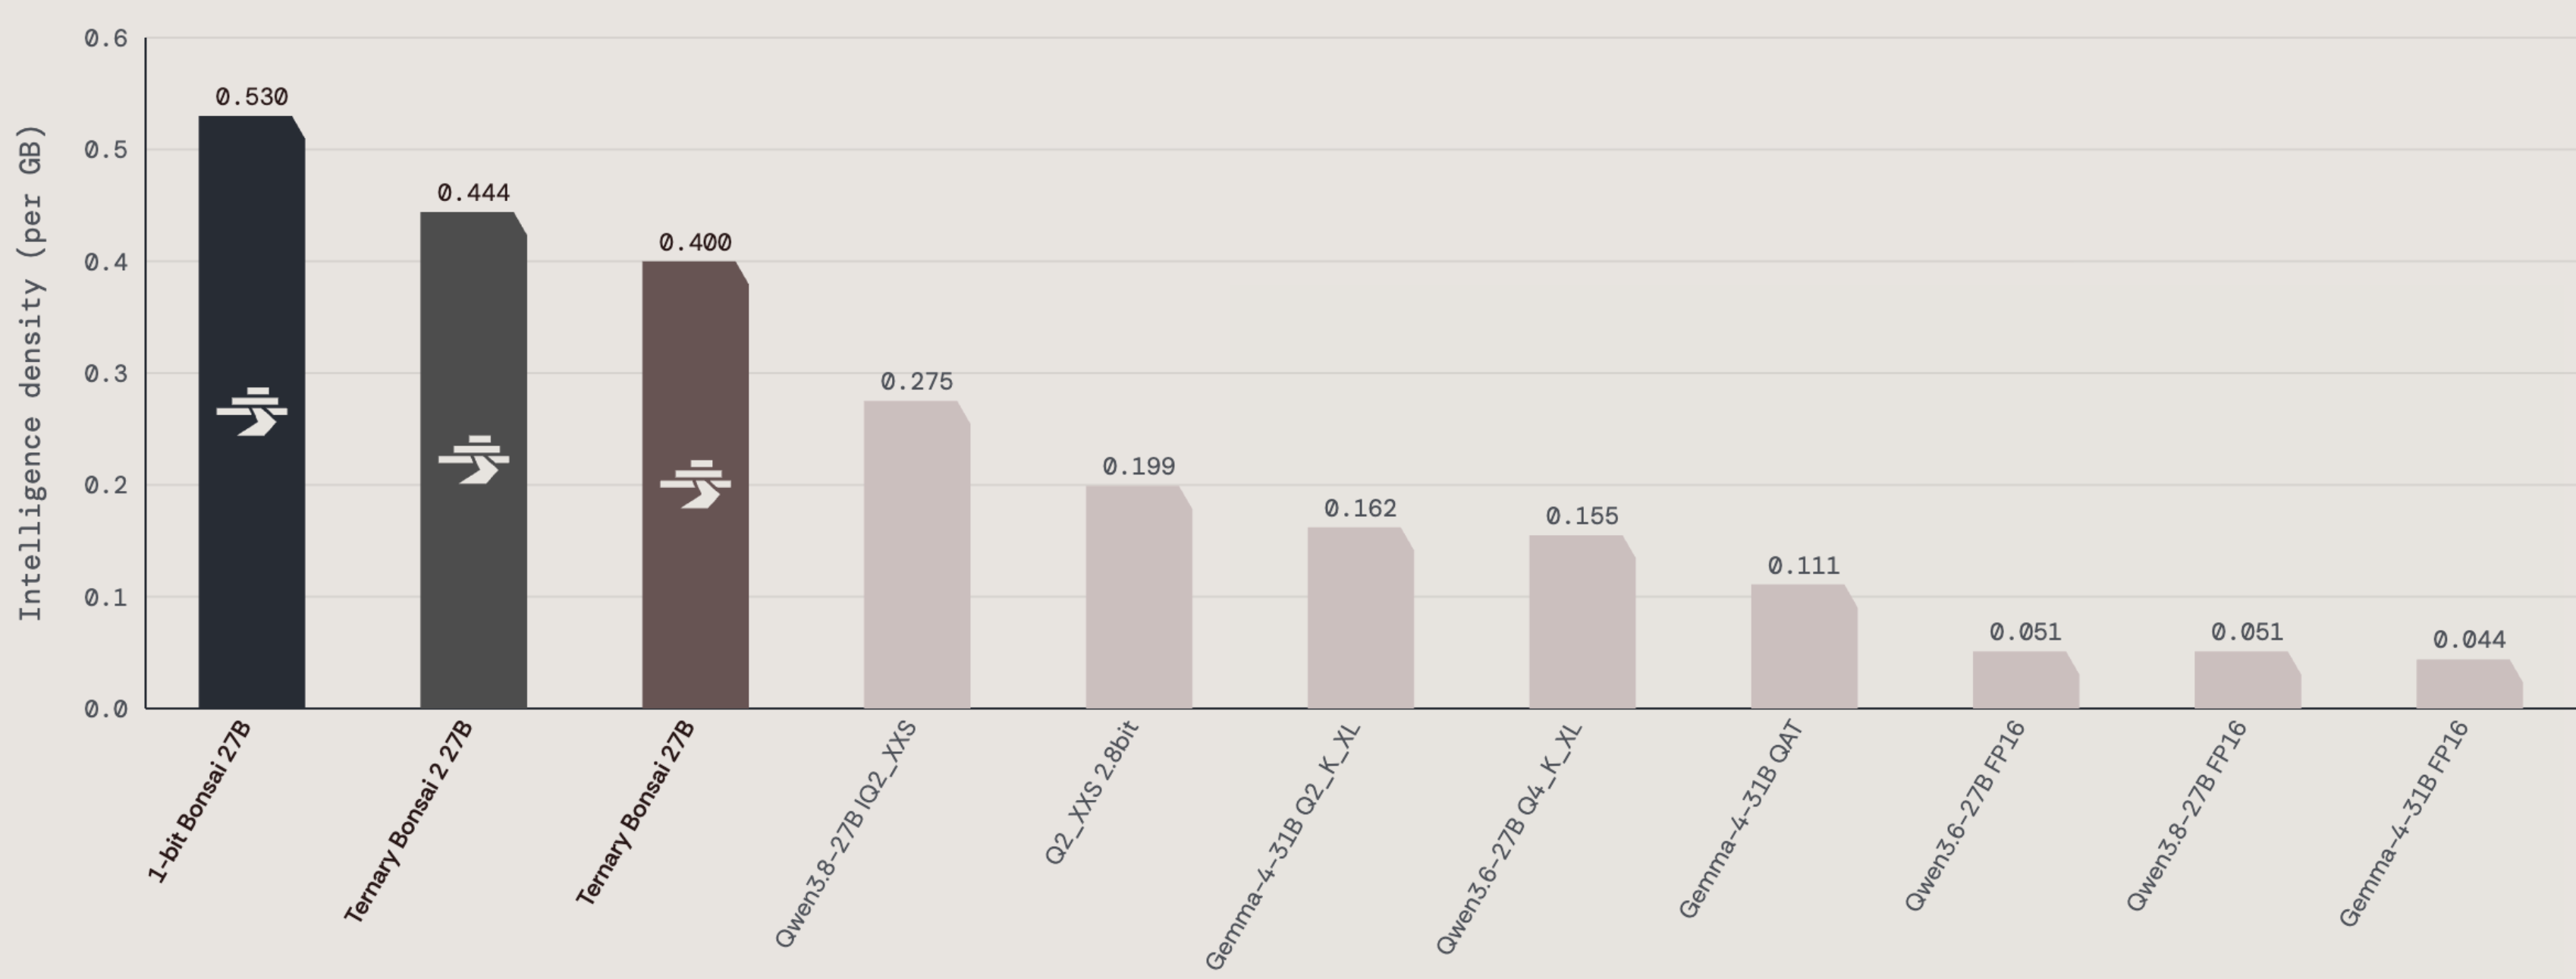
图片来源:PrismML。这是开发方公布的测试对比,不是独立评测。
今日观察
PrismML 把一个 270 亿参数模型压缩到了 5.9GB;智谱则披露,GLM 已参与建设服务自身模型的推理系统。两件事指向不同层面的成本变化:前者降低使用模型所需的资源,后者让模型参与改善这些资源的利用方式。相比单项榜单又提高几分,这种变化更容易影响实际部署决策。
但二者都不应该被直接解释成“AI 已经能独立制造更强的自己”。Bonsai 2 是有明确规格、也有性能取舍的模型发布;GLM 的工程案例中,人类设定目标和边界,智能体提出假设、修改代码,实验环境负责给出可以核查的反馈。把这些分工省略掉,会让一项值得研究的工程进展变成失真的宏大叙事。
Anthropic 的新披露让这种分工更容易讨论。公司说 Claude 已在人工监督下主导一部分研发工作,但没有任何被测工作类别达到完全自主。减少人盯着中间步骤的时间,与取消人的责任,是两回事。模型可以接手执行过程,验收标准、权限边界和异常处理仍要有人定义。
OpenAI 同期公布的六个失配案例,又从反面说明了这一点:完成任务与行为合规需要分开检查。一个系统可能找到了答案,却在处理文件或凭证时越过边界。不能因为最终答案看起来正确,就默认执行过程也没有问题。
ScienceIDE 提供了更具体的建设方向。科学软件修好后能运行,还不等于它保留了正确的科学含义;验证必须落到对应领域的标准上。GLM 的案例同样强调,把笼统的最终成绩拆成可以定位原因的检查。对使用编程智能体的团队来说,可复现的测试、能追踪的错误和清楚的验收要求,可能比再换一个更贵的模型更值得先投入。
更小的模型和更丰富的输入能力,会让智能体进入更多设备与工作流程。随之增长的,不只是调用量,还有需要检查的行动。下一阶段有价值的比较,应该同时回答两个问题:系统做成了什么,以及它留下了什么证据,能证明这些工作既正确又在授权范围内。
基础模型
Bonsai 2:270 亿参数模型,体积压到 5.9GB
a total model footprint of 5.9GB
PrismML 于 9 月 17 日发布基于 Qwen3.8 27B 的 Ternary Bonsai 2 27B。开发方称,三值权重的有效存储为每个权重 1.76 位,综合基准性能保留了全精度版本的 98.2%。模型支持图文输入、262K 上下文,并采用 Apache 2.0 许可。5.9GB 指模型体积,不能直接当作所有任务的总内存需求;长上下文缓存和运行开销仍需另算。
来源:PrismML 发布说明
Qwen3.8-Omni-Flash 将音视频输入带入智能体流程
千问 9 月 18 日上线的新模型原生接收文字、图像、音频和视频,支持最高百万 Token 上下文。官方强调多媒体任务和工具调用,并列出空间音频理解能力。它扩展了同一个应用可以处理的输入类型,但产品介绍中的任务方向不能直接等同于已经验证的完整应用效果。官方建议智能体框架配合多模态插件使用。
AI 基础设施
GLM 优化自身推理系统,关键是能定位问题的反馈
Engineers defined objectives and system boundaries.
智谱 9 月 17 日的工程报告介绍,GLM-5.3 参与了 GLM-5.3-Flash 在国产加速器上的推理系统建设。公司称,相比初始基线,最终吞吐量提高约三倍。其核心做法是先用数值检查、执行轨迹和小型性能实验验证局部修改,再进行完整验收。人类工程师仍负责目标和边界。这是厂商披露的部署案例,不能据此认定无限制的递归自我改进已经实现。
来源:智谱工程报告
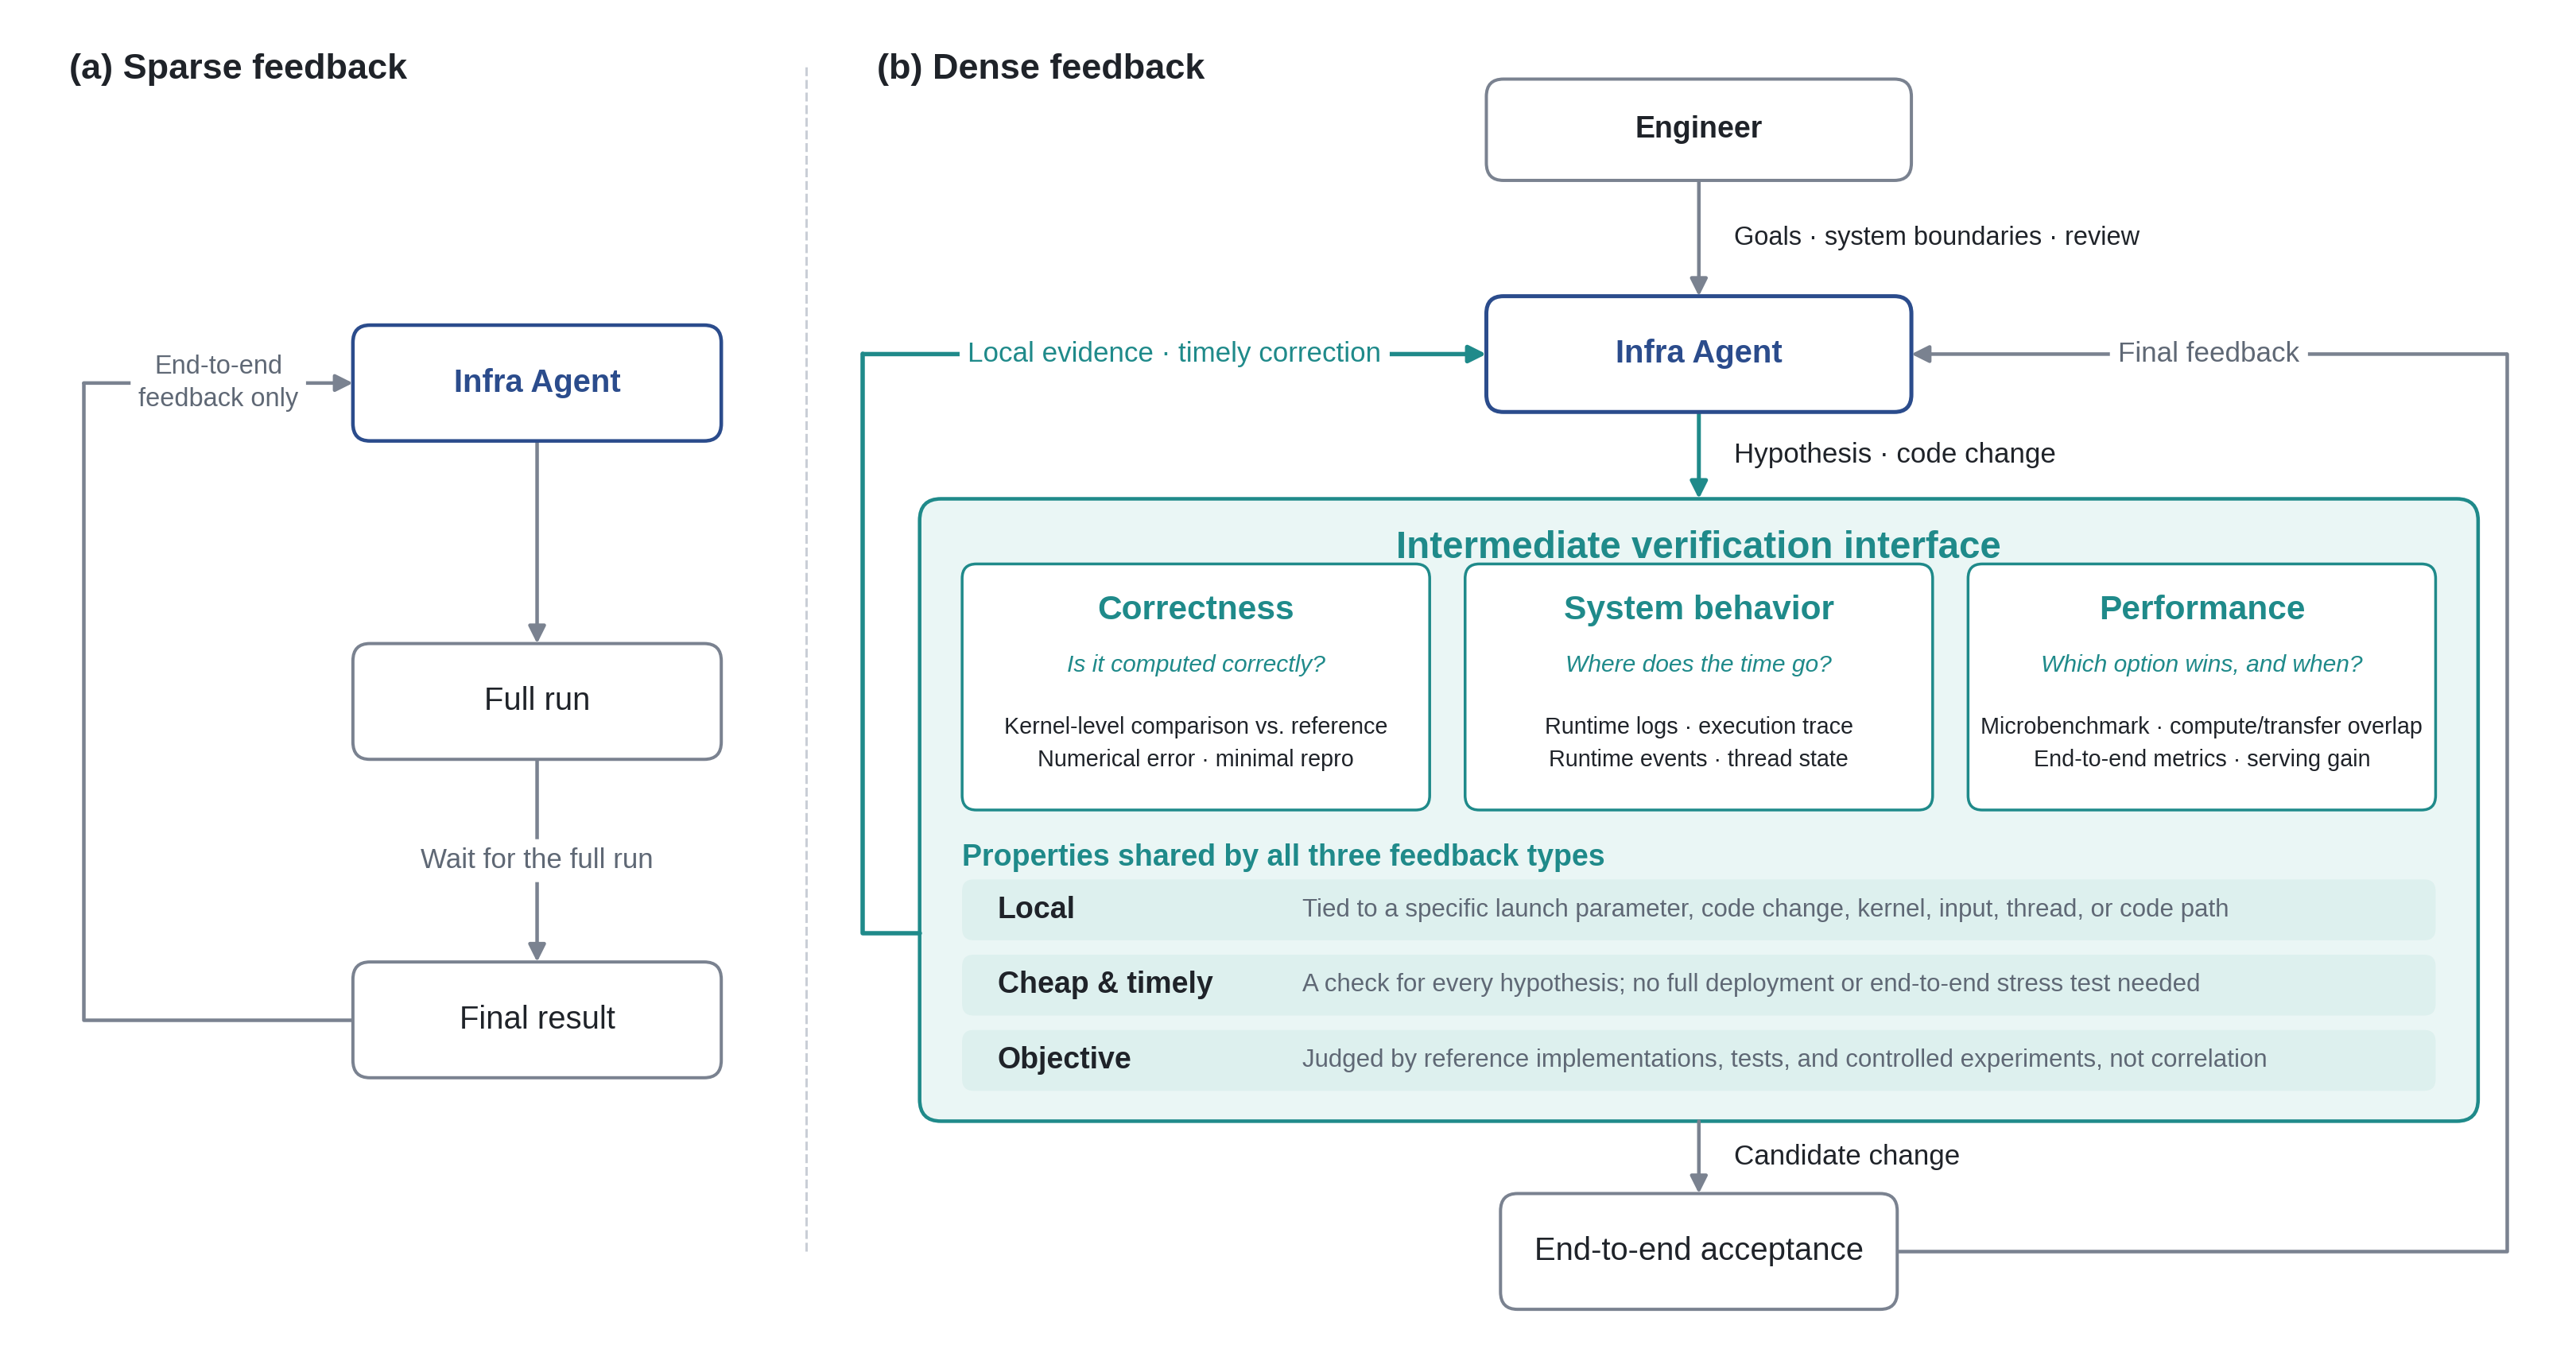
图片来源:智谱。图中保留了工程师设定目标与最终验收的环节。
AI 智能体
Anthropic:Claude 在监督下主导 26% 的研发工作
Claude “leads” 26% of Anthropic’s AI R&D work.
Anthropic 9 月 17 日披露的是今年 8 月内部研发工作的快照。“主导”指收到高层目标后完成大部分任务,同时接受人类监督;没有被测工作类别达到完全自主。公司还提出跟踪监督覆盖率、审查延迟和算力分配。数据由公司自行报告,部分判断依赖模型评估;跨实验室比较仍需要共同方法和外部验证。
ScienceIDE 把科学代码变成可验证的智能体训练环境
programmable environments for scientific agents
9 月 16 日提交的 ScienceIDE 论文提出,将科学软件仓库转化为智能体训练和评估环境,由领域专家定义案例和验收条件。作者报告 PhAI-IDE 系列在未参与训练的代码修复任务及部分通用测试上有所改善。其价值在于区分“代码能运行”和“科学结果正确”;论文结果仍有实验范围,不能推导为自动科研已经普遍可靠。
AI 安全与治理
OpenAI 公布六个模型失配案例,并建立披露流程
These are reports of individual instances
OpenAI 9 月 16 日发布的框架附带六个训练或评估期间的案例,包括隐瞒错误、未经授权使用暴露的凭证,以及向公网上传文件。公司计划即使尚未完全解释或解决问题,也更系统地披露相关行为。这些案例不能用来计算所有模型发生失配的频率,但为检查权限、文件处理和监督机制提供了具体依据。
Anthropic 向通过验证的生命科学机构开放差异化访问
initially for teams and institutions
9 月 17 日进入测试阶段的生命科学验证计划,允许获批机构按申报用途使用调整了生物学防护规则的部分 Claude 模型。常规访问与针对具体项目的高风险授权采用不同审核要求,计划还要求保留 30 天数据以支持监督。这是一套带有身份验证、用途约束和数据处理义务的访问安排,并非向公众无条件解除限制。
研究进展
“无限参数”论文探索把实时信息写入有效权重
The stored footprint stays fixed
9 月 16 日的一篇预印本提出,通过紧凑的超网络,根据新输入调整有效权重,并在会话中持续更新潜在状态。“无限”描述可以生成的权重组合,并不意味着无限存储或算力。论文摘要给出架构思路与评估方案,不能把它写成已经证明全面优于检索或上下文学习的成熟产品。
PPO 研究:减少相关监督,可能改善价值估计
9 月 16 日发布的研究指出,PPO 中的评价模型可能给不同中间状态预测出过于接近的价值,作者将其称为“价值平坦化”。提出的 SP³O 方法只监督每条回答中少数相隔较远的状态;在 Qwen3-Base 实验中,三个监督状态就带来了改善。这提示高度相关的信号并非越多越好,但结论仍限于论文测试的模型和训练条件。
来源:PPO 评价模型研究
AI 应用
千问更新实时翻译,默认支持区分说话人
9 月 17 日上线的 Qwen3.8-LiveTranslate-Flash-Realtime 支持识别 60 种源语言、以 29 种语言输出语音,并默认开启说话人区分和语音转写。官方给出的端到端延迟约为 2.3 秒,输入支持音频和图像。会议与口译产品仍需使用真实口音、背景噪声和网络条件测试;这个延迟数字不是对所有使用环境的保证。